Hallucination IA : pourquoi l'IA invente avec aplomb, et comment protéger ce que tu livres à tes clients
Une hallucination, c'est une réponse fausse mais plausible. Pourquoi les modèles en produisent, comment les repérer, quoi vérifier avant de livrer.
8 min de lecture
# Hallucination IA : pourquoi l'IA invente avec aplomb, et comment protéger ce que tu livres à tes clients
Une hallucination d'IA est une réponse fausse mais plausible qu'un modèle de langage formule avec assurance : une source, un chiffre ou une citation inventés. OpenAI parle d'« affirmations plausibles mais fausses » générées par les modèles de langage. Côté agents, voir les garde-fous d'un agent IA.
Vérifié le 21/10/2026 sur les sources primaires citées.
L'essentiel à retenir :
- Une hallucination n'a pas l'air d'une erreur : elle a le ton d'une réponse juste. C'est ce qui la rend dangereuse dans un livrable.
- D'après OpenAI, les modèles hallucinent en partie parce que leur entraînement et leurs évaluations récompensent la réponse tentée plutôt que l'aveu d'incertitude.
- Le risque monte sur les faits précis et rares : dates, noms, références, chiffres, citations.
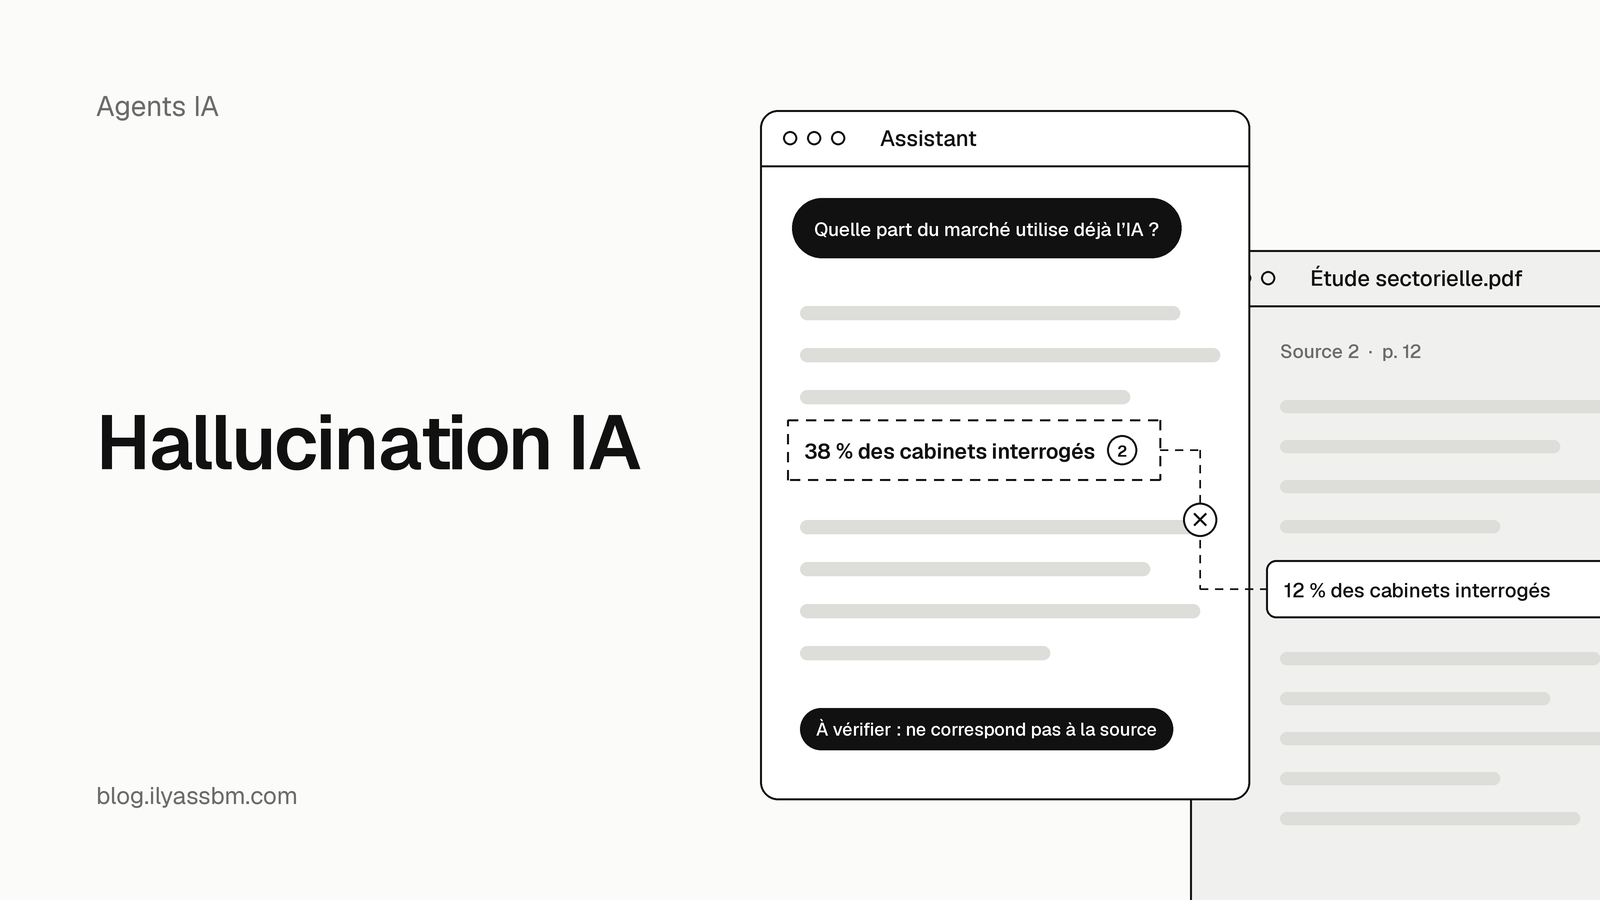
- Une réponse avec des sources n'est pas à l'abri : une source peut exister et ne pas dire ce qu'on lui prête.
- Ce qui protège ton client, c'est ta vérification : ouvrir les sources, relire chaque chiffre, nom et citation, et garder la décision.
Ce guide explique ce qu'est une hallucination, à quoi elle ressemble dans un travail de consultant, de coach ou de freelance, pourquoi les modèles en produisent, quand le risque est le plus fort, comment la repérer avant de livrer, et pourquoi des sources citées ne suffisent pas.
Qu'est-ce qu'une hallucination d'IA ?
Une hallucination d'IA est une affirmation fausse qu'un modèle présente avec la même assurance qu'une affirmation vraie. Dans son article Why language models hallucinate du 5 septembre 2025, OpenAI la définit comme une situation où un modèle génère avec assurance une réponse qui n'est pas vraie (« a model confidently generates an answer that isn't true »).
Les formes les plus courantes dans un travail de bureau :
- une fausse source : un article, un rapport ou une décision qui n'existe pas ;
- un faux chiffre : un pourcentage, une date ou un montant sans origine ;
- une fausse citation : une phrase attribuée à quelqu'un qui ne l'a jamais dite ;
- un faux résumé d'un document réel : le document existe, mais le résumé lui fait dire autre chose.
Une hallucination se distingue de deux autres erreurs. Une erreur de calcul se voit en refaisant le calcul. Une information datée était vraie à un moment et ne l'est plus. L'hallucination, elle, n'a jamais été vraie, et rien dans le ton de la réponse ne le signale.
L'exemple donné par OpenAI est parlant. Interrogé sur le titre de la thèse de l'un des auteurs de l'étude, un assistant très utilisé a produit avec assurance trois réponses différentes, toutes fausses. Même chose pour sa date de naissance.
À quoi ressemble une hallucination dans ton travail ?
Dans ton travail, une hallucination ressemble à une phrase normale d'un livrable, qui passe la relecture parce qu'elle a l'air juste. Les trois types d'erreurs ci-dessous sont des exemples génériques, pas des cas vécus :
- Une référence de loi inventée dans une note. L'article cité a un numéro plausible et un intitulé crédible, mais il n'existe pas, ou il traite d'autre chose.
- Un chiffre de marché sans source dans une proposition. Le modèle complète ta demande par un ordre de grandeur qui a l'air précis. Personne ne l'a jamais mesuré.
- Un résumé de réunion qui attribue une phrase à la mauvaise personne. Le compte rendu est fluide, mais une décision ou une objection change de bouche.
L'OWASP, qui publie un classement des risques des applications de modèles de langage, range ces cas sous LLM09 : Misinformation. Elle cite parmi les formes du problème les inexactitudes factuelles et les affirmations sans fondement, particulièrement nuisibles dans des contextes sensibles comme la santé ou le droit.
Pourquoi les modèles hallucinent-ils ?
D'après OpenAI, les modèles hallucinent parce que leur entraînement et la façon dont on les évalue récompensent la réponse tentée plutôt que l'aveu d'incertitude. L'article du 5 septembre 2025 et l'étude associée, Why Language Models Hallucinate (Kalai, Nachum, Vempala et Zhang, 4 septembre 2025), donnent deux raisons. Précision utile : trois des quatre auteurs sont affiliés à OpenAI.
Première raison : l'entraînement ne voit pas de « faux ». Un modèle apprend d'abord en prédisant le mot suivant dans de très grandes quantités de texte. Ce texte n'est pas étiqueté vrai ou faux ; le modèle ne voit que des exemples de langage fluide. L'orthographe ou les parenthèses suivent des règles régulières, donc ces erreurs disparaissent. Un fait rare et arbitraire, comme la date d'anniversaire d'une personne peu connue, ne se déduit d'aucune règle. C'est là que naissent les hallucinations.
Deuxième raison : les évaluations récompensent le pari. OpenAI compare la situation à un QCM. Si tu ne connais pas la réponse, tenter ta chance te donne une petite probabilité de marquer un point ; laisser la case vide te garantit zéro. La plupart des évaluations de modèles notent de la même façon, uniquement sur la précision : un modèle qui devine finit mieux classé qu'un modèle prudent qui dit « je ne sais pas ». Les phases d'entraînement qui suivent devraient corriger ces erreurs, mais n'y parviennent pas complètement pour cette raison.
Le fonctionnement d'un modèle de langage, sans jargon, est expliqué dans l'article LLM. Ici, une seule idée compte : le modèle produit la suite la plus plausible d'un texte. Plausible ne veut pas dire vrai.
Quand le risque est-il le plus fort ?
Le risque est le plus fort sur les faits précis, rares ou invérifiables par le modèle : dates, noms propres, références, chiffres, citations. C'est la catégorie que l'article d'OpenAI désigne comme la source des hallucinations, celle des faits arbitraires et peu fréquents qu'aucun schéma ne permet de prédire.
Quatre situations demandent plus de vigilance :
- Les faits rares ou précis. Plus une information est pointue et peu répétée, plus le modèle doit la reconstituer au lieu de la retrouver.
- Les demandes de sources. Demander « donne-moi des sources » pousse le modèle à produire des références. S'il n'en trouve pas de vraies, il peut en fabriquer de plausibles.
- Les sujets que le modèle n'a pas pu voir. Un modèle est entraîné sur des textes arrêtés à une date. Sans recherche web, il ne connaît pas ce qui s'est passé ensuite, et peut combler le vide.
- Les longues chaînes de tâches. Quand un agent IA enchaîne des étapes, une affirmation fausse produite tôt peut servir de base aux étapes suivantes. Tu ne vois souvent que le résultat final.
L'OWASP ajoute un risque qui touche l'utilisateur plus que le modèle : la confiance excessive. Elle la décrit comme le fait d'accorder trop de confiance au contenu généré sans en vérifier l'exactitude, ce qui fait entrer des données fausses dans des décisions.
Comment repérer et limiter les hallucinations avant de livrer ?
On repère une hallucination en vérifiant ce que le modèle affirme contre une source que tu as ouverte toi-même, et on la limite en cadrant la demande. Aucune méthode ne les supprime ; ces étapes réduisent le risque qu'une erreur arrive chez ton client.
1 - Demande les sources, puis ouvre-les
Une source citée n'est une preuve qu'une fois ouverte. Vérifie qu'elle existe, qu'elle est de la date annoncée et qu'elle dit bien ce que la réponse lui fait dire.
2 - Fais travailler l'IA sur tes documents
Quand la réponse doit venir d'un document précis (un contrat, un compte rendu, une étude du client), donne-lui ce document et demande-lui de s'y tenir. La technique qui consiste à faire répondre un modèle à partir de tes documents est traitée dans l'article RAG. L'OWASP la cite parmi les mesures qui réduisent le risque, et l'étude d'OpenAI précise que la recherche documentaire n'est pas une solution complète : quand elle ne trouve pas de réponse sûre, le modèle peut encore deviner.
3 - Autorise « je ne sais pas » dans ta consigne
Écris-le noir sur blanc : « si tu ne sais pas, dis-le », « marque à confirmer ce que tu ne peux pas sourcer ». L'article d'OpenAI rappelle que son Model Spec (le document qui décrit le comportement attendu de ses modèles) juge préférable d'indiquer une incertitude ou de demander une précision plutôt que de fournir avec assurance une information qui peut être fausse.
4 - Relis chaque chiffre, nom et citation
Ce sont les trois points où les hallucinations se logent le plus souvent. Un chiffre sans source vérifiable sort du livrable ou devient « à confirmer ». Une citation non retrouvée mot pour mot sort aussi.
5 - Garde la décision
L'outil prépare, tu signes. L'OWASP recommande une supervision humaine et une vérification des faits, en particulier pour les informations critiques ou sensibles.
Scénario type, pas un résultat : un consultant reçoit une note de synthèse préparée par un outil d'IA pour un client. Il ouvre chaque source citée, retire celle qui n'existe pas, remplace une citation qu'il ne retrouve pas par une reformulation sourcée, et marque « à confirmer » les affirmations qu'il ne peut pas vérifier. Il livre ensuite une note plus courte, dont chaque phrase tient.
Une réponse avec des sources est-elle à l'abri ?
Non : une source peut exister et ne pas dire ce que la réponse lui fait dire. Les outils qui citent leurs sources, comme les modes de recherche approfondie ou les moteurs de réponse, réduisent le travail de recherche, pas celui de vérification.
Trois écarts reviennent quand tu ouvres les sources :
- la source existe, mais traite d'un autre sujet ;
- la source dit quelque chose de proche, mais moins fort, ou sous condition ;
- la source est ancienne, et l'information a changé depuis.
L'étude d'OpenAI le dit à sa façon : la recherche et le raisonnement « ne sont pas des panacées ». La vérification propre à chaque outil est détaillée dans les articles deep research et Perplexity. La règle générale reste la même : seule la source ouverte compte.
Qui est responsable si je livre une erreur inventée par l'IA ?
Vis-à-vis de ton client, c'est toi qui livres, donc c'est ton travail qui est en cause, quel que soit l'outil utilisé pour le préparer. Ce guide n'est pas un avis juridique : si ton contrat ou ton secteur encadre l'usage de l'IA, c'est ce cadre qui s'applique.
Dois-je dire à mon client que j'utilise l'IA ?
Ça dépend de ton contrat et de la nature des données qu'il te confie. La question de la transparence et des données client est traitée dans le guide « Agent IA pour consultant » du blog.
Si je demande à l'IA « es-tu sûre ? », est-ce suffisant ?
Non. Le modèle peut confirmer une erreur avec le même aplomb que la première fois, ou changer de réponse sans meilleure raison. Seule une source que tu ouvres toi-même tranche.
Les hallucinations vont-elles disparaître ?
OpenAI écrit qu'elles restent « un défi fondamental » pour tous les grands modèles de langage, tout en contestant l'idée qu'elles seraient inévitables : un modèle peut s'abstenir quand il n'est pas sûr. Pour ton travail, la vérification reste nécessaire quel que soit l'outil.