RAG en IA : faire répondre l'IA à partir de tes documents, et savoir quand ça vaut le coup
Le RAG fait chercher l'IA dans tes documents avant de répondre. Comment ça marche, quand un indépendant en a besoin, et ce que le RAG ne corrige pas.
9 min de lecture
# RAG en IA : faire répondre l'IA à partir de tes documents, et savoir quand ça vaut le coup
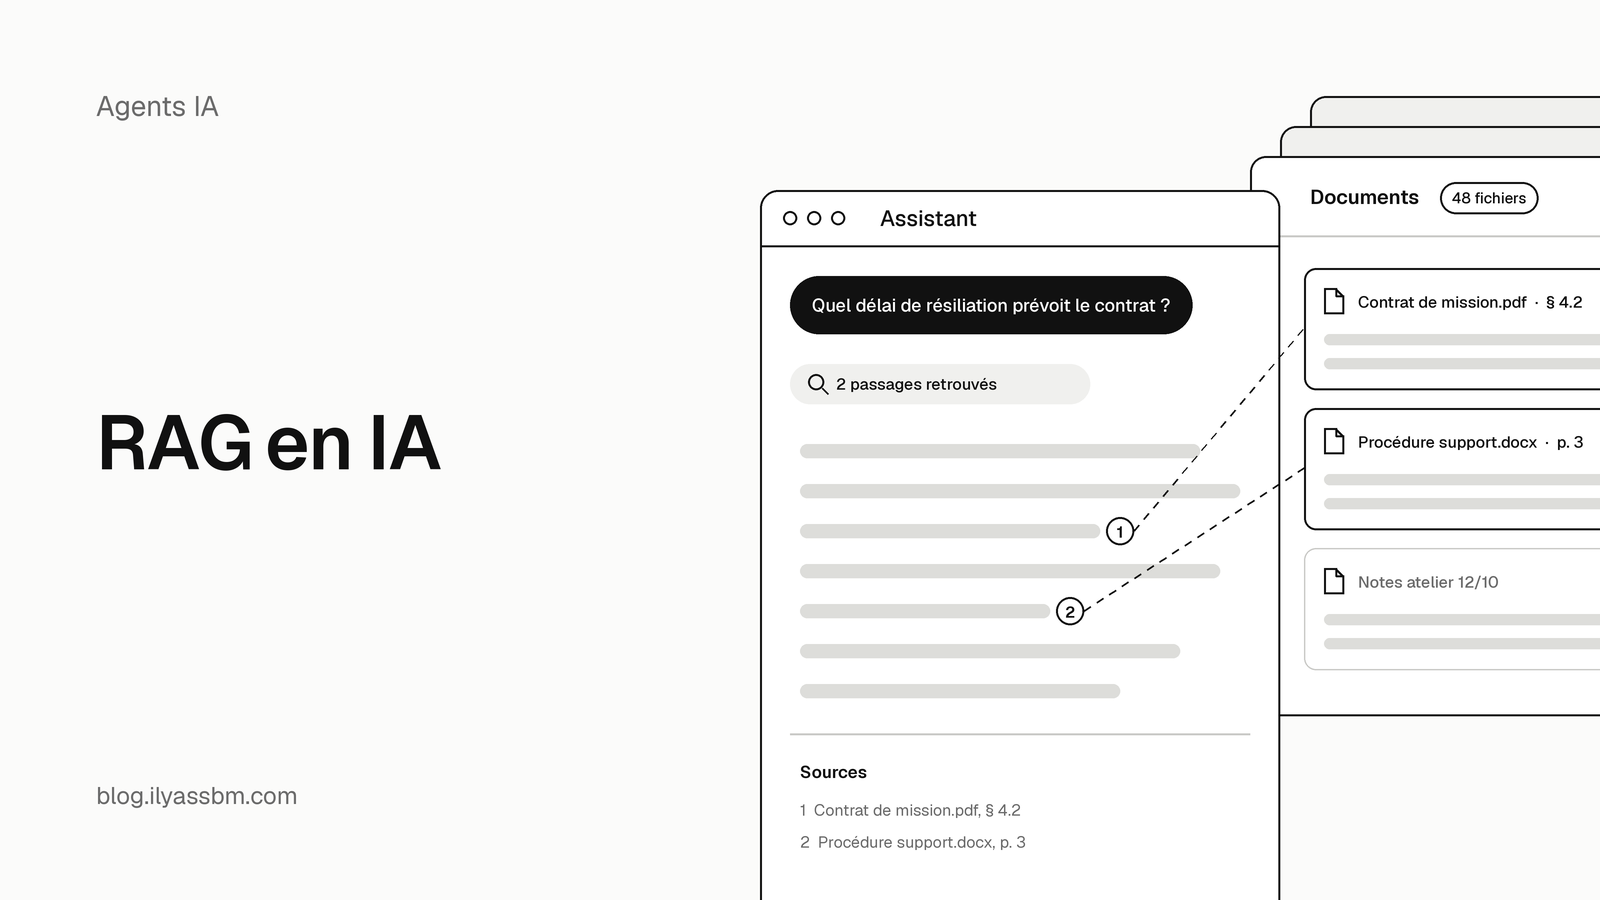
Le RAG (retrieval-augmented generation, ou génération augmentée de récupération) est une technique qui fait chercher une IA dans des documents choisis avant qu'elle réponde. La réponse s'appuie alors sur ces passages et peut les citer. Pour le modèle lui-même, voir l'article LLM.
Vérifié le 21/10/2026 sur les guides de la DGE et de France Num.
L'essentiel à retenir :
- Le RAG ajoute une étape de recherche avant la réponse : l'IA retrouve les passages utiles dans tes documents, puis rédige à partir d'eux.
- Son premier intérêt pour un indépendant, c'est la traçabilité : chaque réponse peut renvoyer au passage qui la justifie.
- Le RAG réduit le risque d'hallucination sans le supprimer. Le guide de la DGE le dit en toutes lettres.
- Il répond mal à certaines demandes : comparer des documents entre eux, lire des tableaux, résumer tout un corpus d'un coup.
- Tu n'as pas forcément à en construire un : des solutions grand public existent avant toute option sur mesure.
- Les documents de tes clients restent sous ta responsabilité : choisis ce que tu y mets, retire les données personnelles inutiles, vérifie qui y a accès.
Ce guide explique ce qu'est le RAG, comment il fonctionne, ce qu'il change par rapport à un modèle de langage seul, dans quels cas un consultant, un coach ou un freelance en a besoin, à quel niveau s'équiper, et quelles précautions prendre avec les documents de tes clients.
Qu'est-ce que le RAG ?
Le RAG est une méthode qui donne à un modèle d'IA générative des connaissances tirées de tes propres documents au moment où il répond. Dans son guide *Comment l'IA générative peut-elle aider votre entreprise ?* (novembre 2024), la Direction générale des Entreprises (DGE) le définit comme « une technique qui consiste à améliorer ou augmenter les réponses des modèles d'IA générative, en les alimentant avec des connaissances issues des bases de données de votre entreprise ». Elle ajoute : « elle permet à un LLM de « consulter » vos données d'entreprise (en temps réel) avant de fournir une réponse ».
Le point de départ est simple. Un modèle de langage a appris sur des données figées au moment de son entraînement. Il ne connaît ni ton contrat de mission, ni la documentation produit de ton client, ni tes notes de réunion. Le RAG ne modifie pas le modèle : il lui apporte, question par question, les passages qui comptent.
Comment fonctionne un RAG, étape par étape ?
Un RAG fonctionne en deux temps : une recherche dans tes documents, puis une rédaction à partir de ce qui a été trouvé. La DGE parle d'un module de récupération et d'un module de génération. Avant ces deux temps, il faut préparer les documents.
1 - Préparer les documents
Les documents sont convertis en texte, nettoyés, puis découpés en segments. Le guide de la DGE détaille ce prétraitement : conversion (y compris des documents scannés), suppression des doublons et des documents contradictoires, découpage en segments, ajout de métadonnées comme le chapitre ou la date, puis vectorisation. La vectorisation convertit chaque segment en une séquence de nombres, rangée dans une base qui permet de retrouver vite les segments proches d'une question.
2 - Retrouver les passages utiles
Quand tu poses une question, le module de récupération cherche les documents ou extraits les plus pertinents. Il ne lit pas toute ta base : il sélectionne un petit nombre de passages jugés les plus proches de la demande.
3 - Rédiger la réponse à partir de ces passages
Le module de génération reçoit ta question et les passages retenus, puis rédige la réponse. C'est là que se joue la traçabilité : un RAG bien réglé indique d'où vient chaque élément, ce qui te permet d'ouvrir le passage et de vérifier.
4 - Vérifier la réponse
Cette étape n'est pas technique, elle est à toi. La DGE liste parmi les difficultés le fait que la recherche peut manquer des documents pertinents, par exemple quand ils emploient des synonymes, ou parce que l'outil ne garde que les premiers résultats. Si le bon passage n'a pas été retrouvé, la réponse sera incomplète, même si elle est bien écrite.
Certains éditeurs décrivent ce mécanisme dans leur documentation. La page de Notion sur la sécurité de Notion AI (en anglais) explique par exemple que l'outil cherche les pages pertinentes dans un index de l'espace de travail, puis envoie ces pages et la demande au modèle qui rédige la réponse. C'est le même schéma en deux temps.
Quelle différence avec un LLM seul ?
La différence tient à l'origine de la réponse : un LLM seul répond à partir de ce qu'il a appris, un RAG répond à partir de passages retrouvés dans tes documents. La DGE rappelle que les LLM « ne sont pas informés du contexte spécifique » d'une entreprise et que leurs données sont figées lors de l'entraînement.
| LLM seul | LLM avec RAG | |
|---|---|---|
| Origine de la réponse | Ce que le modèle a appris pendant l'entraînement | Passages retrouvés dans les documents fournis, puis rédaction |
| Connaissance de tes documents | Aucune, sauf ce que tu colles dans la conversation | Celle des documents placés dans la base |
| Traçabilité | Difficile : pas de passage à citer | Possible : la réponse peut renvoyer à ses sources |
| Risque d'hallucination | Présent | Réduit, toujours présent d'après la DGE |
Le guide de la DGE est clair sur ce dernier point : « bien que le RAG réduise les hallucinations », celles-ci « peuvent toujours se manifester ». Une réponse peut citer un vrai passage et en tirer une affirmation que le passage ne contient pas. Le mécanisme est détaillé dans l'article hallucination IA.
Le RAG n'est pas non plus le seul moyen de donner du contexte à un modèle. Coller un document dans une conversation en est un autre. La différence apparaît quand les documents deviennent trop nombreux ou trop longs pour être collés à chaque fois : la recherche fait alors le tri à ta place.
Quand un indépendant en a-t-il besoin ?
Un indépendant a besoin d'un RAG quand il interroge régulièrement le même ensemble de documents et qu'il doit pouvoir justifier chaque réponse par un passage précis. Quand le besoin est de rédiger un texte général ou de réfléchir à voix haute, un modèle seul suffit.
La DGE propose cinq questions pour juger de la pertinence d'un RAG. Elles portent sur l'ampleur des bases documentaires, leur fréquence de changement, leur organisation, le besoin d'une réponse rédigée en langage naturel et la « traçabilité de l'information (pouvoir citer les références des documents de la base documentaire employés pour répondre) ». Si la traçabilité compte pour ton client, c'est un signal fort.
Les cas où le RAG aide :
- répondre à des questions récurrentes à partir d'une documentation stable ;
- retrouver une clause, une procédure ou une décision dans un dossier volumineux ;
- rédiger un e-mail ou une réponse qui doit reprendre des éléments exacts d'un document. La DGE cite la rédaction d'e-mails parmi les cas d'usage simples.
Les cas où il aide peu, toujours d'après la DGE :
- les recommandations ou les comparaisons entre documents ;
- les données en tableaux ;
- les demandes qui exigent de lire tous les documents, comme un résumé ou une synthèse d'un grand nombre de documents.
Scénario type, pas un résultat : une agence solo assure le support d'un client à partir de la documentation produit de ce client. Les questions des utilisateurs reviennent souvent et changent peu. Elle place la documentation dans un outil qui retrouve les passages utiles, et chaque réponse proposée renvoie au passage qui la fonde. Avant d'envoyer, elle relit la réponse et ouvre le passage cité. Si la documentation ne couvre pas la question, elle répond elle-même plutôt que de laisser l'outil combler le vide.
As-tu besoin de construire le tien ?
La plupart du temps, non : un indépendant peut commencer par une solution existante avant d'envisager un outil sur mesure. La fiche France Num distingue trois niveaux, que l'on peut résumer ainsi.
1 - Les solutions généralistes
France Num les classe au niveau débutant. Ce sont des services en ligne proposés par les grands acteurs du numérique et de l'IA, où tu déposes des documents et poses des questions. L'outil de Google présenté dans l'article NotebookLM fonctionne dans cet esprit, avec des réponses qui renvoient aux sources fournies. Le guide de la DGE note que si tu choisis un logiciel commercial existant, tu n'as pas à te soucier de l'architecture technique.
2 - Les logiciels spécialisés
Ce sont des outils conçus pour un usage ou un métier précis. Ils demandent plus de paramétrage que les solutions généralistes, et ton choix dépend de ton métier plus que de la technique.
3 - Le sur-mesure
Un prestataire, ou toi si tu as les compétences, assemble la chaîne complète décrite plus haut. Le guide de la DGE précise que, dans ce cas, le prétraitement des données et la mise à jour de la base sont à la charge de celui qui développe, ce qui demande du temps et des compétences.
Une précision sur la source : la fiche France Num est rédigée par un prestataire, Ask This Guy, qui vend ce type de service. Elle mentionne des montants et des durées que ce guide ne reprend pas. Pour ton choix, la question utile est la suivante : as-tu un ensemble de documents stable, des questions récurrentes et un besoin de citer tes sources ? Si oui, commence par le niveau 1 et passe au suivant uniquement si tu bloques sur un point précis.
France Num invite aussi à regarder la nationalité du fournisseur. Pour des documents clients, ce point compte autant que la qualité des réponses.
Quelles précautions avec les documents de tes clients ?
La précaution principale consiste à décider, document par document, ce qui entre dans la base, et à vérifier qui peut l'interroger. Le guide de la DGE consacre une section au risque de fuite de données et liste la confidentialité parmi les thèmes à aborder avec un prestataire.
1 - Retirer ce qui n'a pas besoin d'y être
La DGE évoque l'anonymisation et la pseudonymisation des données personnelles, au regard du RGPD. Si une question de support n'a pas besoin du nom du client final, ce nom n'a pas besoin d'être dans la base.
2 - Régler les accès
La DGE recommande une gestion des accès : un RAG ne doit pas permettre à quelqu'un de retrouver un document qu'il n'aurait pas le droit d'ouvrir autrement. Si tu partages un outil avec un collaborateur ou un client, vérifie ce que chacun peut voir.
3 - Garder la base propre
Pour limiter les erreurs, la DGE propose, face aux hallucinations, une « mise en qualité des données » qui élimine les contradictions internes de la base. Deux versions d'une même procédure dans la base, et l'outil peut citer la mauvaise.
4 - Vérifier ce que ton contrat permet
Avant de déposer les documents d'un client dans un service tiers, relis ce que ton contrat et ses règles internes autorisent. La question des données client et de la transparence est traitée dans agent IA pour consultant.
Le RAG empêche-t-il l'IA d'inventer ?
Non. Le guide de la DGE indique que le RAG réduit les hallucinations mais qu'elles « peuvent toujours se manifester ». Il réduit le risque en donnant au modèle des passages précis, et il te donne un moyen de vérifier : ouvrir la source citée.
Mes documents servent-ils à entraîner le modèle ?
Pas par le mécanisme du RAG lui-même : la DGE le décrit comme une consultation de tes données avant la réponse, pas comme un nouvel entraînement. Ce que l'éditeur fait ensuite de tes documents dépend de ses conditions et de tes réglages. Lis la page de confidentialité de l'outil que tu utilises avant d'y déposer quoi que ce soit.
C'est quoi un « RAG agentique » ?
C'est un RAG utilisé par un agent, qui peut enchaîner plusieurs recherches avant de répondre au lieu d'une seule. La fiche France Num décrit un chatbot qui « peut enchaîner plusieurs recherches successives », la recherche devenant un outil parmi d'autres pour l'agent. La DGE parle d'« agentisation du RAG ». Pour la notion d'agent, voir l'article agent IA.
Quels documents ne pas y mettre ?
Ceux qui contiennent des données personnelles inutiles à la question, ceux que ton contrat ne t'autorise pas à confier à un tiers, et les versions périmées qui contredisent les documents à jour. Une base plus petite et cohérente donne des réponses plus faciles à vérifier qu'une base complète et contradictoire.